Lorem ipsum
Lorem ipsum dolor sit amet consectetur. Mattis venenatis justo ornare rhoncus aenean pretium amet donec. Auctor tempor ultrices scelerisque.
Read More

Lorem ipsum
Lorem ipsum dolor sit amet consectetur. Mattis venenatis justo ornare rhoncus aenean pretium amet donec. Auctor tempor ultrices scelerisque.
Read More
Lorem ipsum
Lorem ipsum dolor sit amet consectetur. Mattis venenatis justo ornare rhoncus aenean pretium amet donec. Auctor tempor ultrices scelerisque.
Read More
Lorem ipsum
Lorem ipsum dolor sit amet consectetur. Mattis venenatis justo ornare rhoncus aenean pretium amet donec. Auctor tempor ultrices scelerisque.
Read More
Lorem ipsum
Lorem ipsum dolor sit amet consectetur. Mattis venenatis justo ornare rhoncus aenean pretium amet donec. Auctor tempor ultrices scelerisque.
Read More
What Does This Do Better Than Others?
Covasant accelerators go beyond traditional DQ frameworks by enabling:
- Automates 60–80% of ingestion effort through agentic ETL generation and semantic mapping.
- Understands domain context, improving accuracy for healthcare, BFSI, manufacturing, and telecom datasets.
- Eliminates RAG retrieval errors with domain-aware vector index tuning.
- Provides 100% lineage visibility for structured and unstructured assets.
- Deploys faster using pre-built industry UDMs, DQ rules, and ingestion templates.
- Ensures governance through human-in-the-loop approvals and medallion architecture alignment.
How It Works
Workflow

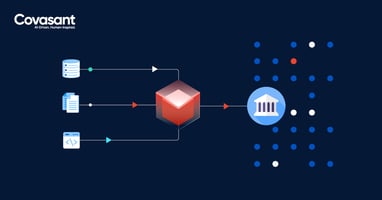
Structured Ingestion
- Automated Discovery
Scans legacy ETL, schemas, and data lineage. - Semantic Mapping
LLMs understand table meaning, relationships, and business logic. - Pipeline Generation
Creates production-grade PySpark/SQL pipelines with DQ, logging, and error handling. - Agentic Optimization
Transformation agents optimize pipelines for GCP, Databricks, Spark. - Human-in-the-Loop Review
Architects validate logic and approve deployment. - Governed Deployment
Pipelines land in Bronze–Silver–Gold layers with CI/CD and monitoring.
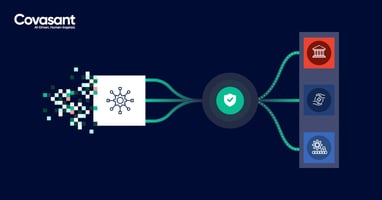
Unstructured Ingestion
- Multi-Modal Data Extraction
Supports PDFs, logs, transcripts, images, EHRs, financial docs. - Adaptive Chunking & Embedding
Domain-aware chunking and optimized embeddings. - Vector Index Optimization
Similarity tuning, ontology mapping, and automated index rebuilds. - Continuous Feedback Loops
Tracks retrieval performance and regenerates vectors for precision.

Tech Stack
- Databricks, PySpark, Spark, Beam
- GCP-native ingestion (Pub/Sub, Dataflow, Composer, BigQuery)
- LLM-driven semantic mapping and code generation
- Vector DBs: Pinecone, Weaviate, FAISS
- Orchestrator agents + Human-in-the-loop governance
- Integrated DQ, privacy masking, CI/CD, and observability
Use Cases
- Cloud migrations (Informatica, Talend, ADF → GCP/Databricks)
- Enterprise data lakehouse modernization
- Industry-specific ingestion (HL7, FHIR, FIX, OPC-UA, EHR, financial statements)
- RAG/GenAI applications requiring high-precision retrieval
- Customer 360, Supply Chain Analytics, Risk & Compliance pipelines
- Healthcare, BFSI, Telecom, Manufacturing, Retail ecosystems

Business Benefit of Using This
- 10x faster pipeline creation
- 50–70% reduction in migration and ingestion effort
- 60% TCO reduction due to automation and optimized pipelines
- 95% AI-ready data with rich metadata and traceability
- Reduced hallucinations through domain-aware vector optimization
- Consistent governance with structured approvals and medallion deployment
- Accelerated cloud adoption for GCP, Databricks, and Spark workloads